硬體加速器用於處理大量資料。它們有助於快速運行複雜的AI模型。這些設備讓AI和機器學習工作更輕鬆、更有效率。近年來,湧現許多新型AI硬體。如今,各公司針對不同的AI任務開發專用平台:
微軟正在為其 HoloLens 頭戴式裝置研發人工智慧晶片。
谷歌在雲端使用張量處理單元(Tensor Processing Unit)進行人工智慧開發。
亞馬遜正在為 Alexa 開發人工智慧晶片。
蘋果公司為 Siri 和 Face ID 開發了人工智慧處理器。
特斯拉為自動駕駛汽車打造人工智慧處理器。
隨著人工智慧軟體變得越來越智能,硬體也在不斷更新換代以適應這一變化。
關鍵要點
硬體加速器可以加快人工智慧任務的處理速度,幫助您快速處理大量資料。
有多種加速器,例如 GPU 和 ASIC。每種加速器都適用於特定的 AI 任務。請選擇最符合您需求的加速器。
硬體加速器能耗更低,成本更低,這能讓您的AI專案運作得更好。
並行計算將大型任務拆分成較小的任務。這些小任務同時運行,進而提升人工智慧的效能。
未來,人工智慧硬體將配備專用晶片和邊緣運算技術,將使運行速度更快、效率更高。
人工智慧中的硬體加速器
速度與效率
在人工智慧領域,處理大量資料需要快速的工具。硬體加速器可以顯著提升資料處理速度。這些設備比普通CPU速度更快,能夠顯著加快機器學習和人工智慧任務的運作速度。
人工智慧加速器的主要類型包括:
圖形處理單元 (GPU)
張量處理單元 (TPU)
專用積體電路(ASIC)
中央處理器 (CPU)
現場可程式閘陣列 (FPGA)
GPU 的特殊之處在於它擁有眾多小型核心。你可以利用它們同時進行大量數學運算。這對於圖像識別或語言處理等人工智慧任務來說非常有用。客製化的 ASIC 晶片是為特定任務而設計的。它們性能強勁且節能。這些加速器可以幫助你更快地訓練模型並降低功耗。
提示:如果使用硬體加速器,您可以在幾個小時內完成人工智慧模型的訓練,而不是幾天。
基準測試可以顯示這些加速器的速度。例如,GPU 的運算速度可達約 15,700 GFLOPS。 TPU 每秒最多可執行 275,000 次 INT8 運算。像 MLPerf Training 這樣的基準測試工具可以幫助您比較不同AI加速器的效能。您可以據此選擇最適合您AI任務的加速器。
賦能深度學習
深度學習模型可以擁有數十億個參數。訓練這些模式需要強大的AI加速器。 FPGA、GPU和ASIC等硬體加速器使這一切成為可能。它們可以幫助您減少記憶體使用量並提高運行速度。這意味著您可以訓練更大的模型而無需擔心記憶體問題。
以下是不同加速器如何幫助深度學習的:
加速器 | 它是如何幫助的 |
|---|---|
圖形處理器 | 它們使用大量處理器來運行複雜的神經網路。因此,你可以更快地訓練深度學習模型。 |
ASIC的 | 它們是為特定的人工智慧任務而設計的。訓練速度更快,能耗更低。 |
FPGA的 | 您可以根據需要更改它們的設計。您可以提高它們的效率,並使其能夠處理大型模型。 |
你還能獲得高頻寬記憶體系統。這些系統可以防止資料卡頓,確保你的AI模型流暢運作。使用多個GPU時,你可以訓練更大的模型。 InfiniBand和NVLink等技術可以幫助你在裝置間快速傳輸數據,從而提高AI任務的效率和規模。
您可以使用資料局部性感知方法來更快地取得資料。
你可以減少訓練期間的溝通量。
你可以改進算術單位以提高速度。
借助這些工具,您可以訓練深度學習模型,用於語音識別、自動駕駛汽車和醫療診斷等高級人工智慧任務。硬體加速器可以幫助您在人工智慧領域獲得更高的準確率和速度。
AI加速器的類型
您可以選擇多種人工智慧加速器。每種加速器都針對特定任務而設計,有些加速器更適合某些特定的人工智慧任務。主要類型包括GPU、NPU、FPGA和ASIC。這些工具可以幫助您更快、更好地進行機器學習。
硬件加速器 | 主要特色 | 優點 | 限制 |
|---|---|---|---|
圖形處理器 | 它們利用多個核心協同工作。 | 非常適合數學運算工作和需要快速處理資料的工作。 | 對於某些工作來說,它不如ASIC晶片好。 |
網絡處理器 | 專為神經網路設計。 | 非常適合深度學習,而且節能。 | 不如FPGA靈活。 |
FPGA的 | 你可以改變它們的工作方式。 | 你可以讓它們適應特殊用途,並快速取得成效。 | 設定和編程難度較大。 |
ASIC的 | 僅用於一項工作。 | 速度非常快,而且完成這項工作耗電量很低。 | 你不能將它們用於其他工作。 |
圖形處理器
GPU 在人工智慧領域應用廣泛。它們可以同時處理多項任務,從而幫助您快速處理大量資料。 GPU 非常適合深度學習和快速求解。您可以更快地訓練模型,並執行諸如圖像識別之類的任務。 GPU 也有助於機器學習中使用的數學運算。
GPU可以同時處理大量資料。
你可以獲得更快的訓練速度和更強大的AI性能。
網絡處理器
神經網路處理單元 (NPU) 專為神經網路而設計,廣泛應用於各種人工智慧產品。 NPU 速度快、能耗低,非常適合深度學習。它們尤其適用於需要快速反應的應用場景,例如自動駕駛汽車或機器人。 NPU 可以輔助處理感測器資料、語音和影像。
NPU(神經網路處理單元)讓人工智慧系統運作得更好。
他們提供快速解答和媒體工作方面的協助。
FPGA的
FPGA 可讓您根據自身需求變更其運作方式。購買後,您可以將其配置用於新的任務。 FPGA 非常適合需要快速結果和高功率的應用。您也可以將其用於需要精細控制的特殊 AI 應用。
FPGA 可用於設計人工智慧硬體。
您可以根據新工作的需要進行更改。
ASIC的
ASIC晶片專為特定類型的AI任務而設計。它們速度極快且節能。 ASIC晶片最適合處理變化不大的任務,例如語音處理或資料中心工作。它們速度快、功耗低,但不能用於其他用途。
專用積體電路(ASIC)是為特定的人工智慧任務而設計的。
既能快速獲得答案,又能節省精力。
提示:選擇人工智慧加速器時,請考慮您的人工智慧任務以及需要進行多少更改。每種類型的加速器都適用於不同的任務。
人工智慧工作負載優化
訓練與推理
人工智慧主要分為兩個步驟。第一步是訓練。訓練需要強大的運算能力,需要重複進行大量的數學運算。強大的AI加速器可以幫助完成這些高難度任務。第二步是推理。推理是指AI分析新的數據並做出決策。這一步對硬體的要求不高,只需要一個加速器甚至一個CPU即可。
注意:加快推理速度可以節省大量成本。許多人工智慧工具,例如詐欺偵測和建議,都需要快速而聰明的推理。
選擇哪種硬體取決於你的工作。以下是一些範例:
<span class="notranslate">EventXtra 6大解決方案</span> | 訓練硬體 | 推理硬體 |
|---|---|---|
銷售預測引擎 | 中央處理器 | 中央處理器 |
影像分類模型 | GPU | 如果需要,可以使用 CPU 或 GPU |
推理方式可能會有所不同。這取決於模型的大小、使用場景以及所需的反應速度。你可能需要進行設定、調優、部署、處理大型模型,或在邊緣運算中使用它們。建立一個優秀的推理系統通常需要專家,而不僅僅是新的硬體。
平行計算技術
你可以透過並行運算來提升人工智慧的效能。這意味著將大型任務拆分成多個小型任務,然後同時執行這些小型任務。人工智慧加速器使用不同的方法來實現這一點:
並行處理將任務指派到多個 CPU 或 GPU 上執行。這使得人工智慧運作得更快、更好。
資料並行處理會將資料分解成多個部分。每個加速器處理一部分資料。最後,將所有結果組合起來。
模型並行化將人工智慧模型拆分。不同的加速器同時處理不同的部分。
這些方法有助於人工智慧應用更快運作。例如,GPU 和 NPU 利用平行處理來輔助深度學習並節省能源。這樣可以獲得更好的結果,並且可以處理更大的人工智慧任務而不會降低速度。
加速器對比
性能和效率
您肯定希望您的AI 專案運行速度快、能耗低。在比較不同的硬體時,您需要檢視它們完成任務的速度和功耗。有些加速器訓練 AI 模型的速度遠遠超過其他加速器。例如,最新的基準測試結果顯示,NVIDIA B300 僅需 9.59 分鐘即可完成訓練。 AMD Instinct MI355X 的速度比舊款機型快 2.8 倍。您可以在下表中查看這些設備的效能比較。
GPU模型 | 訓練時間(分鐘) | 性能增益 |
|---|---|---|
AMD 本能 MI355X | 10.18 | 速度提升高達 2.8 倍 |
NVIDIA B200 | 9.85 | 不適用 |
NVIDIA B300 | 9.59 | 不適用 |
AMD 本能 MI300X | 28 | 不適用 |
AMD 本能 MI325X | 〜20 | 不適用 |
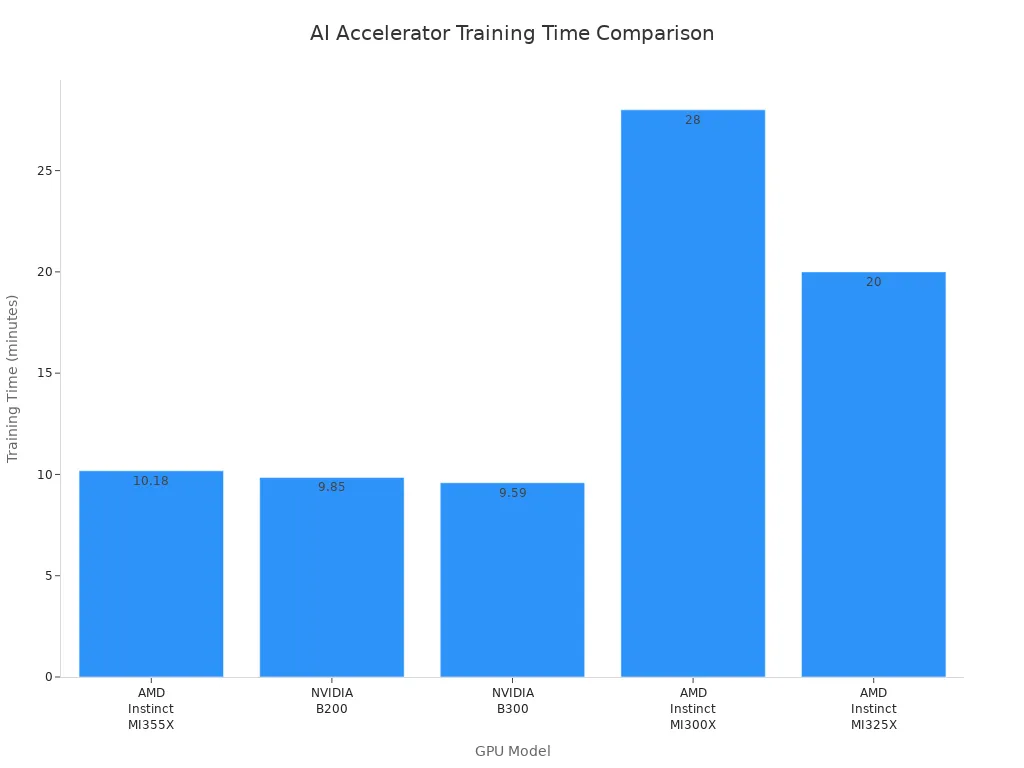
您可以利用這些數據來選擇最適合您需求的AI硬體。更快的訓練速度意味著您可以嘗試更多想法並更快地獲得結果。高性能還有助於您節省能源和成本。選擇合適的硬件,即可同時提升速度和效率。
部署方案
人工智慧可以在很多地方使用,例如雲端或邊緣。每種部署方式都有其自身的優點和限制。在邊緣運行人工智慧可以減少網路延遲,同時也能保護資料隱私並降低成本。例如,邊緣人工智慧可以減少 50 到 200 毫秒的網路等待時間,並將資料成本降低高達 80%。而在雲端,則可能面臨更高的延遲和更大的資料使用量。
以下表格可協助您比較邊緣人工智慧和雲端人工智慧:
方面 | 邊緣人工智慧優勢 | 雲端人工智慧的局限性 |
|---|---|---|
潛伏 | 消除 50-200 毫秒的網路往返延遲 | 資料傳輸導致的高延遲 |
數據隱私 | 在本地處理敏感數據 | 需要將資料傳輸到外部伺服器 |
帶寬優化 | 透過本地處理資料來降低頻寬佔用 | 資料傳輸需要高頻寬利用率 |
降低成本 | 資料傳輸成本降低 60-80%。 | 頻寬增加導致營運成本上升。 |
你應該考慮人工智慧的運作位置。如果你需要快速回應和隱私保護,邊緣人工智慧是最佳選擇。如果你需要強大的處理能力來應對大型任務,雲端人工智慧可能更適合。正確的選擇取決於你的專案和目標。
挑戰與趨勢
集成問題
在人工智慧中使用硬體加速器時,可能會遇到一些問題。您必須確保硬體和軟體能夠良好地協同工作。如果它們不匹配,您的人工智慧模型運行速度可能會很慢。您還需要注意能耗和記憶體的使用情況。對於大型人工智慧模型來說,這一點尤其重要。有時,您需要針對新的人工智慧方法變更配置。下表列出了一些常見問題:
挑戰 | 產品說明 |
|---|---|
透過硬體和軟體的匹配來獲得最佳速度。 | |
資源效率 | 大型人工智慧模型使用更少的能源和記憶體。 |
適應性 | 確保你的系統能夠適應新的人工智慧理念。 |
您可以使用一些新軟體來幫助解決這些問題。例如,SNAX 可以讓您輕鬆連接不同的加速器。它提供了一個簡潔的介面,讓您可以專注於人工智慧開發工作。 SNAX-MLIR 可以幫助您更好地利用記憶體和數據,從而提升人工智慧系統的運行速度。
提示:像 SNAX 這樣的工具可以讓你隨著人工智慧的發展添加新的加速器並更改你的設定。
人工智慧硬體的未來
人工智慧硬體即將迎來重大變革。如今,各公司會針對特定任務開發專用的人工智慧晶片。這些晶片能夠幫助人工智慧系統運作得更快、能耗更低。此外,我們也會看到更多系統採用不同的處理器組合,例如GPU、FPGA和ASIC。這被稱為異構計算。它能夠幫助人工智慧系統針對每個任務獲得最佳效能。
以下是一些未來的發展趨勢:
客製化人工智慧晶片,例如NPU和TPU,正被越來越多地使用。
邊緣運算可讓您在資料擷取地點附近進行資料處理。這可以降低延遲並保護您的資料隱私。
神經形態計算利用類似大腦的設計來節省能源並提高人工智慧的性能。
量子計算或許能夠解決許多難題,但它本身仍有許多問題需要解決。
專家認為人工智慧硬體市場將大幅成長。 2024年,該市場規模為16.55億美元。到2029年,預計將達到52.76億美元。這意味著每年約成長26%。
注意:隨著人工智慧硬體的改進,您將有更多方法使您的人工智慧專案運行得更快、更強大。
在人工智慧領域,硬體加速器能帶來許多好處。這些工具能幫助您提高工作效率,讓您立即做出決策,還能節省成本。請查看下表快速了解:
好處 | 產品說明 |
|---|---|
增強性能 | 使人工智慧運作速度更快、效果更好。 |
能源效率 | 人工智慧工作耗電量更低 |
可擴展性 | 隨著人工智慧的發展,它也能隨之成長。 |
為您的AI專案選擇最佳加速器。新型晶片設計和節能方法將改變未來AI的工作方式。
常見問題
人工智慧中的硬體加速器是什麼?
硬體加速器是一種特殊的晶片或設備。它能加快人工智慧任務的運行速度,幫助電腦處理大數據和複雜模型,而不會降低運行速度。
為什麼需要不同類型的AI加速器?
你需要不同的加速器,因為每個人工智慧任務都是獨一無二的。有些加速器最適合訓練,有些則適合快速反應。選擇合適的加速器,才能獲得最佳速度並節省能源。
你可以在家中使用硬體加速器嗎?
是的,你可以在家裡使用一些加速器。許多筆記型電腦和桌上型電腦都配備了GPU。這些加速器可以幫助你運行用於學習、遊戲或小型專案的AI程式。
硬體加速器如何節能?
硬體加速器能快速完成人工智慧任務,而且比一般CPU功耗更低。這有助於節省能源,降低電費。
人工智慧硬體的未來發展方向是什麼?
你會看到更多用於人工智慧的客製化晶片。這些晶片將使你的設備更聰明、更快速。諸如神經形態晶片和量子晶片等新型設計將改變你使用人工智慧的方式。